ML Basic
https://github.com/andrewekhalel/MLQuestions https://www.1point3acres.com/bbs/forum.php?mod=viewthread&tid=998257&page=1&extra= https://longxingtan.gitbook.io/mle-interview/02_ml
supervised learning
training data includes both the input features and corresponding target labels
classification
Logistic Regression
linear classification, 二分
loss function: Binary Cross-Entropy Loss


logistic regression有closed form 解嘛?
没有闭式解。虽然loss function 是convex的,但求导后得到的是含指数项的非线性方程,无法通过求导令其等于 0,解出 w 和 b 的解析表达式,所以只能用gradient decesent
为什么最好不用MSE当loss?
- non-convex
- vanishing gradients
It leads to a non-convex objective and introduces an extra σ’(z) term in the gradient, which can cause vanishing gradients.
Multiclass Logistic Regression
use softmax instead of softmax

Naive Bayes
P(Y|X) = P(X|Y) * P(Y) / P(X)


Decision Tree
同时支持回归和分类。
classification
每一次分裂的时候,从所有 feature 和所有可能 threshold 里,找一个最能把数据“分干净”的 split。
计算gini impurity,1-sigma(pi^2), pi代表这次分裂时,每个类别的probability
比较这次gini impurity和下次分裂的值。下降值越大,说明这次分裂让数据从 “更乱” 变得 “更纯”,也就是分裂效果越好。
比如一个节点有 10 个样本,7 个 A 类、3 个 B 类,Gini=1-(0.7²+0.3²)=0.42。
如果按 “年龄≤30” 分裂,左边 6 个全是 A,Gini=0;右边 4 个 3B1A,Gini=1-(0.75²+0.25²)=0.375,
加权 Gini=(6/10)0 + (4/10)0.375=0.15,下降 0.27
regression
回归:用MSE/MAE
参数
- max_depth: 树的最大深度,防止过拟合
- min_samples_split:一个叶子中至少有这么多sample,才可以继续分裂
- criterion:gini / entropy / mse
Random Forest
bagging
- bootstrap 有放回采样:每棵树使用不同训练子集
- 特征随机采样:每棵树分裂时,只随机选一部分特征,降低树之间相关性
- 单棵决策树不剪枝、深度大,单树容易过拟合(强学习器)
- 集成方式:分类任务多数投票,回归任务取平均值
- 整体效果:降低模型方差,缓解过拟合,所有树并行训练
boosting
- 串行依次训练模型,后一棵树修正前一棵树的错误,无法并行
- 核心逻辑:不断拟合前序模型的残差 / 加大错分样本权重 基
- 学习器:多用弱学习器(浅层简单决策树)
- 集成方式:所有模型加权组合,而非简单投票
- 整体效果:降低模型偏差,提升整体拟合能力,更容易过拟合
SVM
support vectors: 离超平面最近的样本
目的是找一个hyperplane,使得两个分类中两个最近向量的距离最远
score=w・x_i + b。初始化w=b=0=score. 遍历所有样本(正样本+1, 负样本-1)。如果遍历到第一个正样本,score=0,此时y_i*score=0 < 1,需要更新w和b,让w向正样本特征方向调整、b增大,使score逐渐接近并超过1;
w = w + 学习率*(yX - 正则化项w),b = b + 学习率*y
For non-linearly separable data, SVM uses “soft margin” and “kernel function”.
Soft margin allows a few samples to violate the margin constraint, controlled by the C parameter—smaller C means more tolerance.
Kernel function maps low-dimensional non-linear data to high-dimensional space, like RBF kernel, making data linearly separable in high dimension for hyperplane separation.
Hinge Loss

- 同时要求分类正确,间隔足够
knn
- 可以用于classification, regression
- 训练快,预测慢,适合小样本场景
- 在高维数据中,样本的特征维度很多,大部分样本之间的距离都差不多,KNN 很难找到真正 “近” 的邻居。先用PCA降维。
LDA
N 个样本, D 个原始特征, 一共 C 个类别
- 算 类内散度矩阵 Sw,希望Sw 越小越好(同类挤在一起)
- 算 类间散度矩阵 Sb

- 对 S_w^(-1)*S_b 做特征值分解
- 按特征值从大到小,选前 k 个特征向量,组成投影矩阵 W(D×k)
- 原始数据 × 投影矩阵得到降维后数据 (N×k)
regression
Linear Regression(线性回归):
- loss=MSE
- 对w和b分别求偏导,令其导数为0,则为解
- 在线性回归中,若误差服从Gaussian,则minimize MSE 等价于maximize log p(y | x)

Random Forest Regression(随机森林回归):
- 处理非线性、抗异常值,无需特征归一化
XGBoost/LightGBM(梯度提升回归):
- boosting: 训练一个基础模型,然后重点关注这个模型预测错误的样本,给这些错误样本更高的权重,再训练下一个模型去纠正上一个的错误,重复多次后,把所有弱模型加权组合起来
- CART 回归树是一种二叉决策树,只有两条路:是 / 否. 每个叶子节点输出一个连续数值。XGBoost 就是由很多棵这种树串行加起来组成的强模型。
- 高性能,工业级常用,需调参优化
unsupervised learning
clustering
K-means:
- 最常用,简单高效,需预设聚类数量(K),适合大规模数据
- 随机选择 K 个初始聚类中心;
- 计算每个样本到各中心的距离,把样本分到最近的中心所在簇;
- 重新计算每个簇的中心;
- 重复步骤 2 和 3,直到中心不再变化或达到最大迭代次数
如何确定K值? Elbow Method 画一条曲线:横轴 K,纵轴 SSE(簇内误差平方和),SSE 会随着 K 变大不断下降
找到一个点:下降速度突然变缓,曲线出现一个 “肘”。这个肘对应的 K 就是比较合适的
缺点
- 对初始点敏感,不同初始化结果不一样
- 对异常值敏感,均值会被带偏
- 只能处理凸簇、球形簇,不规则形状不行
- 需要手动指定 K
Hierarchical Clustering(层次聚类):
无需预设K,生成树状聚类结果,适合小中型数据集
DBSCAN:
密度聚类,自动识别任意形状聚类,可检测异常值,适合密度不均数据
- 设定 ε 和 MinPts;
- 核心点:样本的 ε 邻域内至少有 MinPts 个样本;
- 密度可达:若 X 是核心点,Y 在 X 的 ε 内则直接可达;若 Y 在核心点 Z 的 ε 内,Z 又和 X 可达,则 Y 和 X 可达;
- 从核心点出发,将所有密度可达的点划入同一簇;
- 未被划入任何簇的点为噪声点。
GMM(高斯混合模型):
概率型聚类,输出数据属于各聚类的概率,适合软聚类场景
- GMM 假设数据由 K 个 Gaussian distribution 混合生成,K 需要人为预先指定。
- 每个高斯有三个参数:mean (μ)、covariance matrix (Σ)、weight (π)(所有权重之和为 1)。
- 随机初始化:
- mean μ1,…,μK
- covariance matrix Σ1,…,ΣK
- weight π1,…,πK
- E
- 计算每个样本属于每个高斯的 posterior probability
- 对每个样本 x,直接代入 Gaussian PDF 算出密度值。
- 密度值 × 对应 weight,得到加权得分。
- 对所有高斯的得分做归一化,得到该样本属于第 k 个高斯的后验概率。
- M
- ① 更新 mean (μₖ):所有样本的 x 值,乘以各自属于这个高斯的 γₖ(x),再除以所有样本 γₖ(x) 的总和。
- ② 更新 covariance matrix (Σₖ):同样用 γₖ(x) 加权,计算每个样本 x 与当前 μₖ的偏差平方,乘以 γₖ(x) 后平均,最终得到新的协方差矩阵(反映该高斯的离散程度和维度相关性)。
- ③ 更新 weight (πₖ):直接用 “所有样本属于这个高斯的 γₖ(x) 之和”,除以总样本数,本质是 “这个高斯在所有样本中占的平均权重”。
Dimensionality Reduction
PCA
目标:找到数据方差最大的维度并保留,让数据整体方差最大
| |
Sigma矩阵是协方差矩阵,V的每一列是一个特征向量,Lambda矩阵是一个对角矩阵,分别是特征值,也是每个特征向量的方差
一种无监督降维方法,通过线性变换将高维数据映射到低维空间,保留数据中方差最大的方向,减少冗余同时保留关键信息。
- 数据标准化;每个样本先减去每一维特征的均值。(N,D), N为样本数量,D为原始特征数量
- 计算协方差矩阵;Sigma=X_t * X, 形状为(D, D),
- 对协方差矩阵做特征值分解,得到特征值和特征向量。(D个)
- 选择前 k 个最大特征值对应的特征向量,组成投影矩阵(D,k);K必须小于等于D
- 将原始数据投影到 k 维空间,得到降维后的数据。(N, K)
为什么要做数据标准化?
如果特征量纲不同,方差大的特征会主导 PCA 结果,标准化后各特征方差一致,避免量纲影响。
如何选择 k 值?
累计方差贡献率:选择前 k 个特征值,使累计方差占比≥85%-90%;
肘部法则:绘制特征值排序曲线,找 “肘部” 点对应的 k,肘部后特征值下降趋缓,冗余信息多。
PCA 的优缺点?
优点:降维效果好,计算简单,无参数;
缺点:线性变换,无法捕捉非线性关系,降维后特征可解释性差,对异常值敏感。
optimizer
SGD with momentum

- 帮助冲出local minimum and saddle point
- 减少震荡: 如果某个方向梯度一会儿正一会儿负,那么这些梯度在动量里会部分抵消。
- 在正确方向上加速: 如果某个方向很多步梯度都差不多,那这些梯度会不断累积,速度越来越大。
- Momentum accumulates historical gradients, so when the gradient direction is consistent, the accumulated momentum accelerates convergence. When there are oscillations (frequent direction changes), the opposite gradients in history will cancel out, thus reducing oscillations.
AdaGrad

- 每个dim都维护自己的梯度平方和
- 在陡的dimension, 梯度会很大,那么在这个方向上的更新步长会越来越小
- 缺点:梯度平方和是只增不减的,所以学习率会越来越小
RMSProp
- grad_squared=decay_rate⋅grad_squared+(1−decay_rate)⋅dw∗dw
- decay_rate越大,表示对过去梯度保留越多,平滑更强,变化更慢
- 解决了AdaGrad 学习率不断衰减到几乎 0 的问题
- RMSProp fixes AdaGrad’s shrinking learning rate by using an exponential moving average (EMA) of squared gradients instead of a cumulative sum. The decay rate (usually β2=0.9) controls how much recent gradients matter—higher β2 keeps more history, lower β2 focuses on recent steps. This way, the denominator doesn’t keep growing infinitely, so the learning rate stays stable long-term.
Adam

- Adam = Momentum(动量) + RMSProp(自适应学习率) + Bias Correction(偏差矫正)
- moment1 = beta1 * moment1 + (1 - beta1) * dw
- moment2 = beta2 * moment2 + (1 - beta2) * dw * dw
- moment1_unbias = moment1 / (1 - beta1 ** t)
- moment2_unbias = moment2 / (1 - beta2 ** t)
- w -= learning_rate * moment1_unbias / (moment2_unbias.sqrt() + 1e-7)
- Adam 用一阶矩 m_t来平滑梯度方向,用二阶矩 v_t来缩放每个维度的步长,再通过 bias correction 修正初始从 0 开始带来的偏差
Neural Network
neuron
 output=sigmoid(w0x0+w1x1+w2)
可以理解为:
- x0,x1是上一层的两个neuron的输出
- 此处代表输出层的一个neuron,比如二分类问题
梯度消失
 梯度计算依赖于:后面层的激活函数导数和权重矩阵,以及前面层的输出值
- 原因
- 激活函数导数太小
- 以 sigmoid 为例,它的导数最大值只有0.25,大部分时候远小于0.25.于是越前面的层,梯度越接近0
- 初始权重过小
- 激活函数导数太小
- 解决方案
- relu/leakyReLU:确保激活函数梯度不会过于小
- Batch Normalization:确保前面层的输出值不会过小
- 权重初始化策略:让每一层输出的方差保持一致
- Xavier 初始化:sigmoid/tanh

- He初始化:ReLU 及其变体
- Xavier 初始化:sigmoid/tanh
- 架构改善
- 残差连接
- LSTM/GRU
梯度爆炸
- 权重初始化过大
- 梯度过大(relu 梯度=1, tanh在0附近梯度接近1)
- 解决方法
- 梯度裁剪(Gradient Clipping):给梯度设一个阈值,超过就scale
- Batch Normalization(批归一化):标准化每一层输入,让每一层输入的均值为0,方差为1
- 残差连接(Residual Connection):ResNet 的 skip connection,让梯度直接走捷径,避免连乘放大
batch size vs epoch vs iteration
- epoch:把整个训练集完整过一遍
- batch size:一次迭代里,一次性喂给模型的样本数量
- iteration:一次前向传播 + 反向传播 + 更新参数
残差
一个residual block: x→Conv→ReLU→Conv→output
ResNet中,这个block 学习F(x)=H(x)−x, 最后输出y=F(x)+x
可以每隔两三层加一个skip, 比如x->h1->h2->h3->h4, 可以改成
- h2=x+F1(x)
- h4=h2+F2(h2)

Questions
Bias-Variance Tradeoff
Error = Bias² + Variance + Irreducible Error
bagging vs boosting
- bagging: reduce variance
- boosting: reduce bias
train vs test vs val
训练集用来训练模型参数,测试集用来评估最终模型的泛化能力,而验证集是在训练过程中调超参数用的
Underfitting vs Overfitting
Overfitting
- 在train上表现好,在test/val上表现不好
- 解决:
- 增加训练数据/数据增强
- augmentation: we can rotate the image, crop parts of it, or adjust its brightness. This way, the model learns more general patterns rather than fixating on specific, unique details in the training set
- 降低NN的层数/宽度
- For neural networks, we can reduce the number of layers or the number of neurons in each layer to simplify the model structure. A simpler model is less likely to memorize noise or specific details in the training data, thus reducing the risk of overfitting
- 训练角度
- early stopping
- monitor the val loss
- weight decay:w = w * (0.999) - 学习率 * 梯度
- weight decay is often implemented by multiplying the weights by a decay factor less than 1 during each parameter update, which shrinks the weights over time.
- 是L2的一种实现方式,在数学上是等价的
- early stopping
- regularization
- L1: loss + λ * sum of absolute values of weights (L1 norm)
- For L1 regularization, we add a penalty term to the loss function: a regularization parameter multiplied by the sum of the absolute values of all weights
- L2: loss + λ * sum of squared weights (L2 norm)。让所有权重都变小,但不会变为0
- dropout:比如dropout率是0.4,每次前向传播就只有60%的节点是激活的,然后forward的output要/0.6。目的是让model不过分依赖于某些neuron
- L1: loss + λ * sum of absolute values of weights (L1 norm)
- bagging(random forest)
- 增加训练数据/数据增强
激活函数
输入 x = [x1, x2]
隐藏层:
z1 = w1·x + b
h1 = activation(z1) ← 这里用激活函数
输出层:
z2 = w2·h1 + b2
y_hat = σ(z2) ← 输出层一般用 sigmoid/softmax
- sigmoid:
- 适合二分类任务,容易梯度消失。取值在0-0.25之间
- σ(x)=1/(1+e^(-x))
- σ’(x)=σ(x) * (1-σ(x))
- Tanh:
- 适合二分类任务。tanh(x)=2*sigmoid(2x)-1, 取值在(-1,1)中
- 在二分类问题中,一般tanh被用在隐层,而sigmoid被用在输出层
- Relu
- relu(x)=max(0,x)
- 因为结构简单,前向传播还是反向求导,都比 sigmoid/tanh 快很多,大幅提升训练速度
- 神经元死亡
- leaky relu
- LeakyReLU(x)=max(αx,x)
- 负数区给一个小斜率,不让梯度死。
- SiLU / Swish
- SiLU(x)=x⋅sigmoid(x)
- gating: 一个 0~1 之间的数. 0=关掉,信息不给过;1=全开
- self-gating: silu的门控sigmoid(x)来自于input x自己
- smooth, 不会死神经元
- swiGLU
- out = (W1 x) * sigmoid(W2 x)
- 一个线性层做特征,一个线性层做可学习的门控
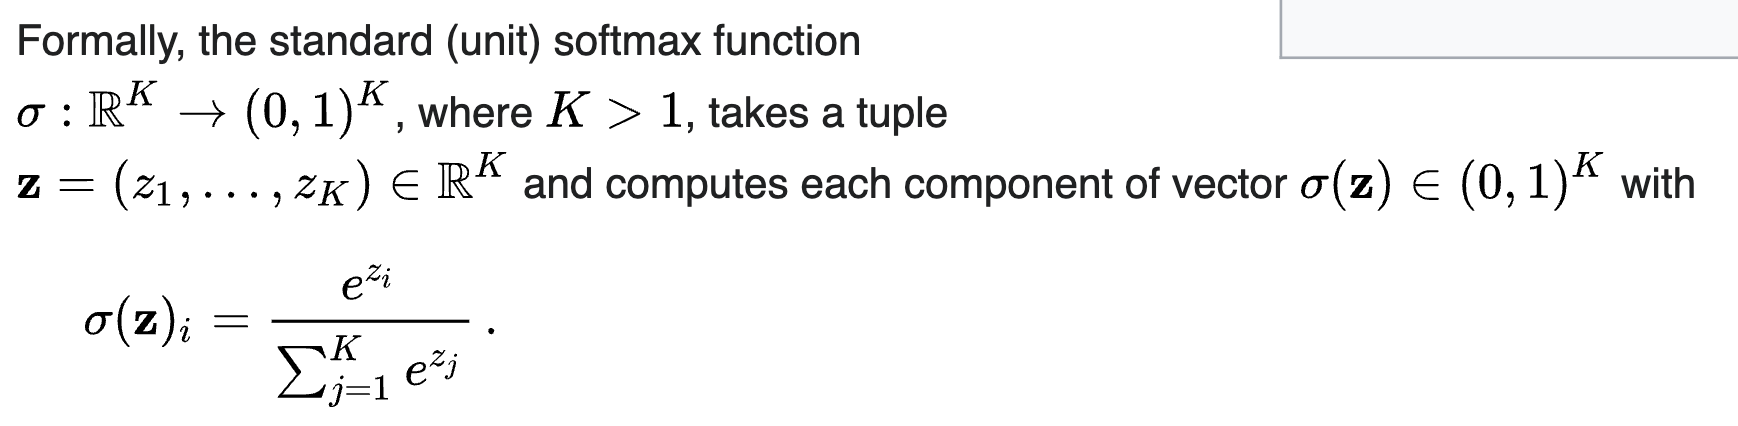
- softmax
- 多分类任务
- 把输出转成和为 1 的概率分布
loss function
- cross entropy
- binary
 模型输出一个正类的logit,然后做sigmoid得到pi。这样的话,和输出两个分类的logit然后做softmax,在数学上是等价的
- multi class
 对于每个样本,模型输出每个分类的logit, 然后做softmax
- 为什么说softmax与cross entropy天生搭配?
- 因为loss对原始输出logit求偏导,得到的是pj-yj. pj表示对于这个样本,预测它属于j类的概率,yj表示0/1,即真实情况下样本是否属于j类
- ∂L/∂z = ∂L/∂p × ∂p/∂z
- binary
- InfoNCE
- contrasative learning
- Cross entropy loss for a N-way softmax classifier

- MSE
- Regression / continuous reconstruction
- y 是连续值,p(y|x) = Gaussian with fixed variance
- model 输出 mean
- loss = MSE
样本不平衡
- data level
- Oversampling: duplicate or generate samples for the minority class, like using SMOTE to create synthetic samples.
- Undersampling: randomly remove some samples from the majority class to balance the distribution.
- loss function level
- Calss Weight: We assign a higher weight to the minority class in cross-entropy loss. 比如990个样本正常,10个样本是诈骗,那么weight = 总数 / 该类数量=100, 如果把诈骗数据预测为正常,loss为100
- Focal loss down-weights easy examples (mostly majority class) and focuses on hard ones.
 pt越大,表明模型对预测越自信,该样本越简单
- algorithm & evaluation level
- Use models more robust to imbalance, like Random Forest, XGBoost with scale_pos_weight.
- Choose proper metrics: F1-score, AUC-ROC, AUC-PR, recall, precision instead of accuracy, since accuracy is misleading.
sgd
- sgd不可以并行
- SGD is easier for online learning
MLE
推导mu和sigma
normal distribution


协方差矩阵
- 对称矩阵,维度与数据维度相同,二维数据对应 2×2 矩阵。
- 对角线元素:各维度的方差,描述单个维度的离散程度,值越大越分散。
- 非对角线元素:两个维度的协方差,描述维度间线性相关性。
- 协方差正负零含义:正 - 两维度同向变化;负 - 两维度反向变化;零 - 两维度无线性相关。
- 二维可视化举例:协方差为 0 时,高斯分布等高线呈圆形;协方差为正时,等高线呈倾斜椭圆,在第一、三象限分布更集中。
confusion matrix
| 预测正例 (Predicted Positive) | 预测负例 (Predicted Negative) | |
|---|---|---|
| 真实正例 (Actual Positive) | TP (True Positive) | FN (False Negative) |
| 真实负例 (Actual Negative) | FP (False Positive) | TN (True Negative) |
- Accuracy: shows how many predictions the model got right out of all the predictions. (TP+TN)/(TP+FN+FP+TN)
- Precision: the quality of the model’s positive predictions. (TP)/(TP+FP)
- Recall: measures how how good the model is at predicting positives. TP/(TP+FN)
- F1-Score: combines precision and recall into a single metric to balance their trade-off. (2 * precision *recall)/(precision+recall)
Convex Function
- 整体只有唯一一个全局最低点
- 随便从哪个点开始梯度下降,一定能找到全局最优解,不会卡半路。
Data drifting
真实世界数据的统计分布随时间 / 环境慢慢变了,和你训练模型时用的数据分布不一样了,导致模型在生产里越用越不准
Transformer
Self-Attention
 a fluffy blue creature roamed the forest
Q
- word embedding: dim=12288. 比如creature的embedding(E4)表示:我是 creature,我是一个名词,我的位置是xxx,我和animal相近
- Wq: “我怎么去问问题”, dim=[dim_model,dim_k]
- Q4: dim=dim_k
- Q4=E4 @ Wq
- 表示creature 这个词生成的问题,比如“有没有词去形容creature"
K
- K4:
- K4 = E4 @ W_k
- 我是一个名词,我可以被找名词的query选中
- W_K 是从词的 embedding 中学习 “如何生成键”,让每个词的 Key 向量能体现它能提供什么信息
- K2: 我是一个形容词,我可以被找形容词的query选中
- Q4 @ K2 高 (dot product, get a scalar)
- 接下来,词语们两两QK相乘,再除以sqrt(dim_k)然后做softmax使得每一列的sum=1
V
- Vi
- Vi = Ei @ W_V
- dimension=128
- updated E4=sum(词语i对creature的权重*Vi), dimension=128
Cross-Attention
A 看 B → 两组不一样的信息,A 去 B 里找关键内容
一般Q是单独的query matrix, K/V是context matrix
Normalization
Batch Normalization
BatchNorm 通常对每个 feature,在 batch 维度上统计 mean/std
Layer Normalization
LayerNorm 对每个 token 自己的 D 个 feature 做 normalization
- h_i = [h_i1, h_i2, …, h_iD], 代表某一层输出的第i个hidden vector
- μ_i = mean(h_i), σ_i = std(h_i). 然后做normalize: z_i = (h_i - μ_i) / σ_i, []
- 最后再做 learnable的scale 和 shift:y_i = γ ⊙ z_i + β。注意γ和β都是D dimension,这里的⊙表示 element-wise multiplication,意思是每个维度都有自己的scalar和shift
fine tune
Lora
- 一般给Wq和Wv加上
- 输出 = Wq * x + B * A * x
- B(dim_model, rank)
- rank 很小(8/16)
- 训练时冻结原权重矩阵,避免破坏预训练结果
sft
- 用人工标注的Q A做有监督训练,提升对特定任务的回答准确性
- 缺点:缺乏对 “答案质量” 的判断能力。比如标注数据里有错误或不优的答案,SFT 会直接学过去
- 万级数据量即可,但对数据质量要求高
- 训练数据格式
- Instruction: 总结下面这段话
- Input: xxx
- Response: xxx
RLHF
- SFT,得到经过SFT的模型
- 训练 Reward Model
- 给 SFT 模型同一个问题,让它生成多个不同回答
- 人类给这些回答排序:哪个好、哪个差、哪个不安全
- 用这些排序数据训练一个奖励模型 RM
- PPO 强化学习
- 模型生成回答
- RM 给回答打分
- 分数高 → 鼓励模型继续这么做
- 分数低 → 惩罚,让模型改掉