Deep Learning
Neural Network
terminology
比如有10000个sample,batch size为100
epoch: 10000个sample全部经过forward+back prop。每次epoch之后,都要进行shuffle,来确保每次选的batch由不同的sample组成
iteration: 一次iteration代表100个sample经过一次forward(算loss)+back propogation(算梯度),然后optimizer.step() 更新权重
batch size越大,梯度估计越精准,但收敛越慢
激活函数:只有用到激活函数,才能引入非线性
back prop umich slides
GD vs SGD
- Batch GD: batch size为N,也就是全量。用所有sample一起做forward+backward, 更新一次参数
- SGD(traditional): batch size为1, 若有10000个sample,则参数更新10000次
- mini-batch SGD: 一次小批很快 & 可并行,梯度精度有噪声,收敛轨迹抖动,但容易跳出局部最优
- 但SGD不保证跳出局部最优
SGD的缺点:
- 批梯度可以把所有样本分到多 GPU 同时算,再把梯度求平均。SGD的第K+1次更新依赖于第K次更新的结果
- 当已经离最小点很近时,噪声让 SGD 难以再精细逼近,需要减小学习率或改用全批梯度
optimization
学习率并不再是一个固定的常数,而是随 epoch 变化的。
衰减函数定义了学习率如何变化,decr代表衰减因子
first pass:SGD
- Momentum:当前的更新方向不仅考虑当前的梯度,还会加入上一轮的更新方向(带权重)。
- AdaGrad:对每个参数分别设定学习率,且随着训练过程调整。累计历史梯度平方的和,用它来缩放学习率(adaptive)
- RMSProp:AdaGrad 的改进。能保持稳定的、不会过快衰减的学习率;收敛更快
- Adam: adaptive+momentum, community fav
regularization
L1
- 会使部分权重收敛为精确的 0 👉 产生稀疏模型;
- 常用于 特征选择(筛掉不重要的特征);
- 对异常值(outliers)不太敏感
L2(widely used)
- 会让权重变小,但不为0 👉 产生密集模型
- 更适合学习复杂模式(因为保留了所有特征)
- 缺点:对异常值较为敏感(因为平方放大了大值)
Dropout
在训练时临时屏蔽部分神经元。在每一次前向传播中,每个神经元都有一定概率被丢弃。这样做能有效地防止网络过度依赖某些神经元,从而提高模型的泛化能力。
通常选择L2或者Dropout
Data Augmentation
在训练数据喂入模型前,对原始图像做增强: 在每个 epoch 中都重新增强,生成不同的样本
增强操作通常是 随机进行 的(如随机翻转、随机旋转)
Early Stop
当验证集性能不再提升时,就停止训练.防止过拟合。
exploding/vanishing gradients
reason:
- 初始输入没有normalized, 导致back prop时,梯度计算得过大,然后一层一层累积效应
- 权重初始化过大/过小 remedies:
- normalize the training/testing/validation data sets
- batch normalization: 每一批,每一层的输出(ReLu之前),做一次normalize
- 权重初始化(Xavier 和 He),让 权重方差与输入/输出维度有关
CNN
Term
- stride: 卷积核(filter)在图像上每次移动的步长
Image Convolution
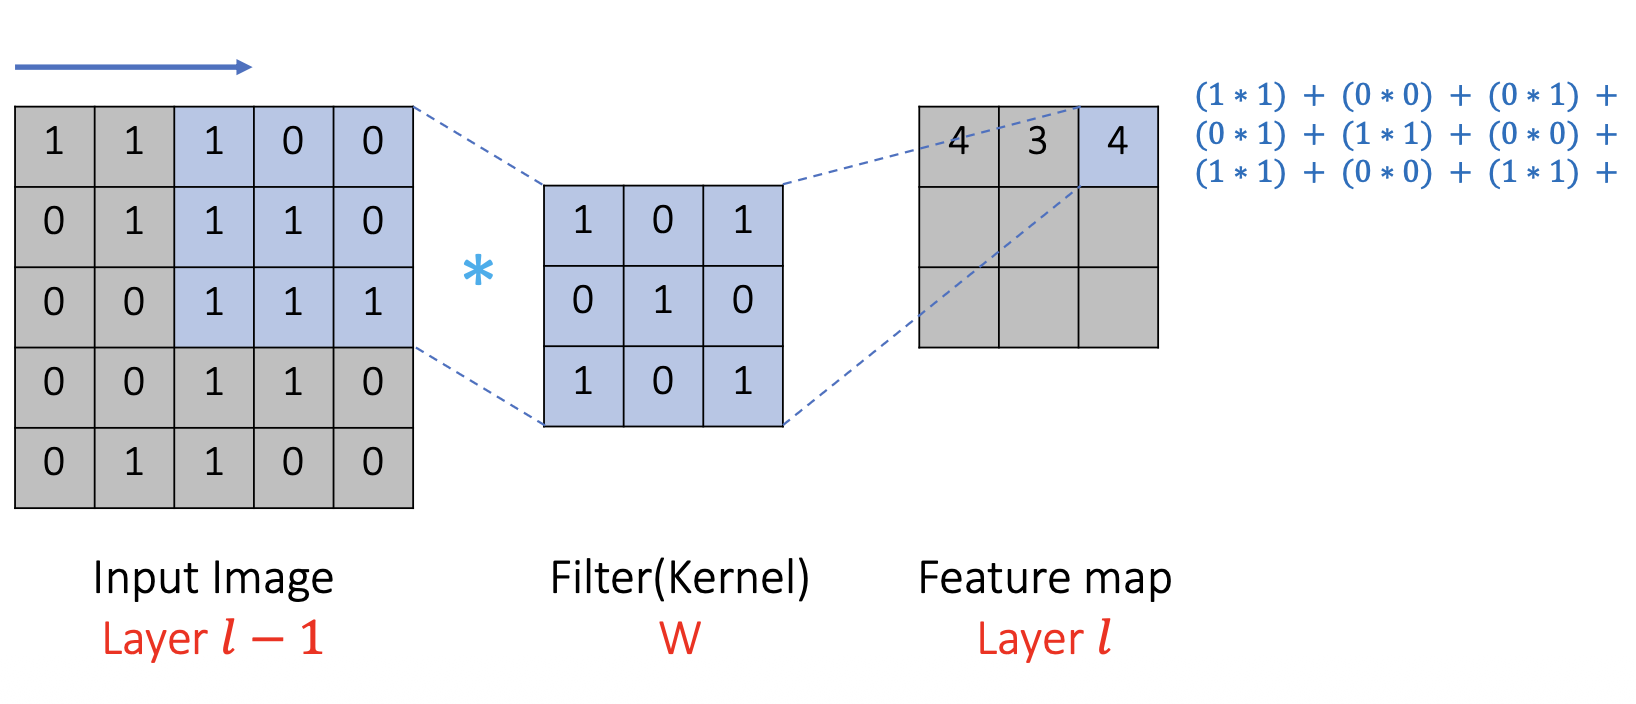 然后逐个元素相乘
Input Image 经过一层filter提取特征,不同的filter有不同的作用
- identity: 输出图像 = 输入图像
- Edge Detection: 当相邻像素差异大 → 产生高值(亮的边); 当相邻像素相似 → 结果接近 0(黑的背景); 结果: 黑底白线,显示图像边缘。
- Sharpen: 锐化边缘
dimension
- same convolution: 如果希望输入和输出图像的维度保持不变,需要对input image首先作padding
- valid convolution: 输出图像的维度会变小
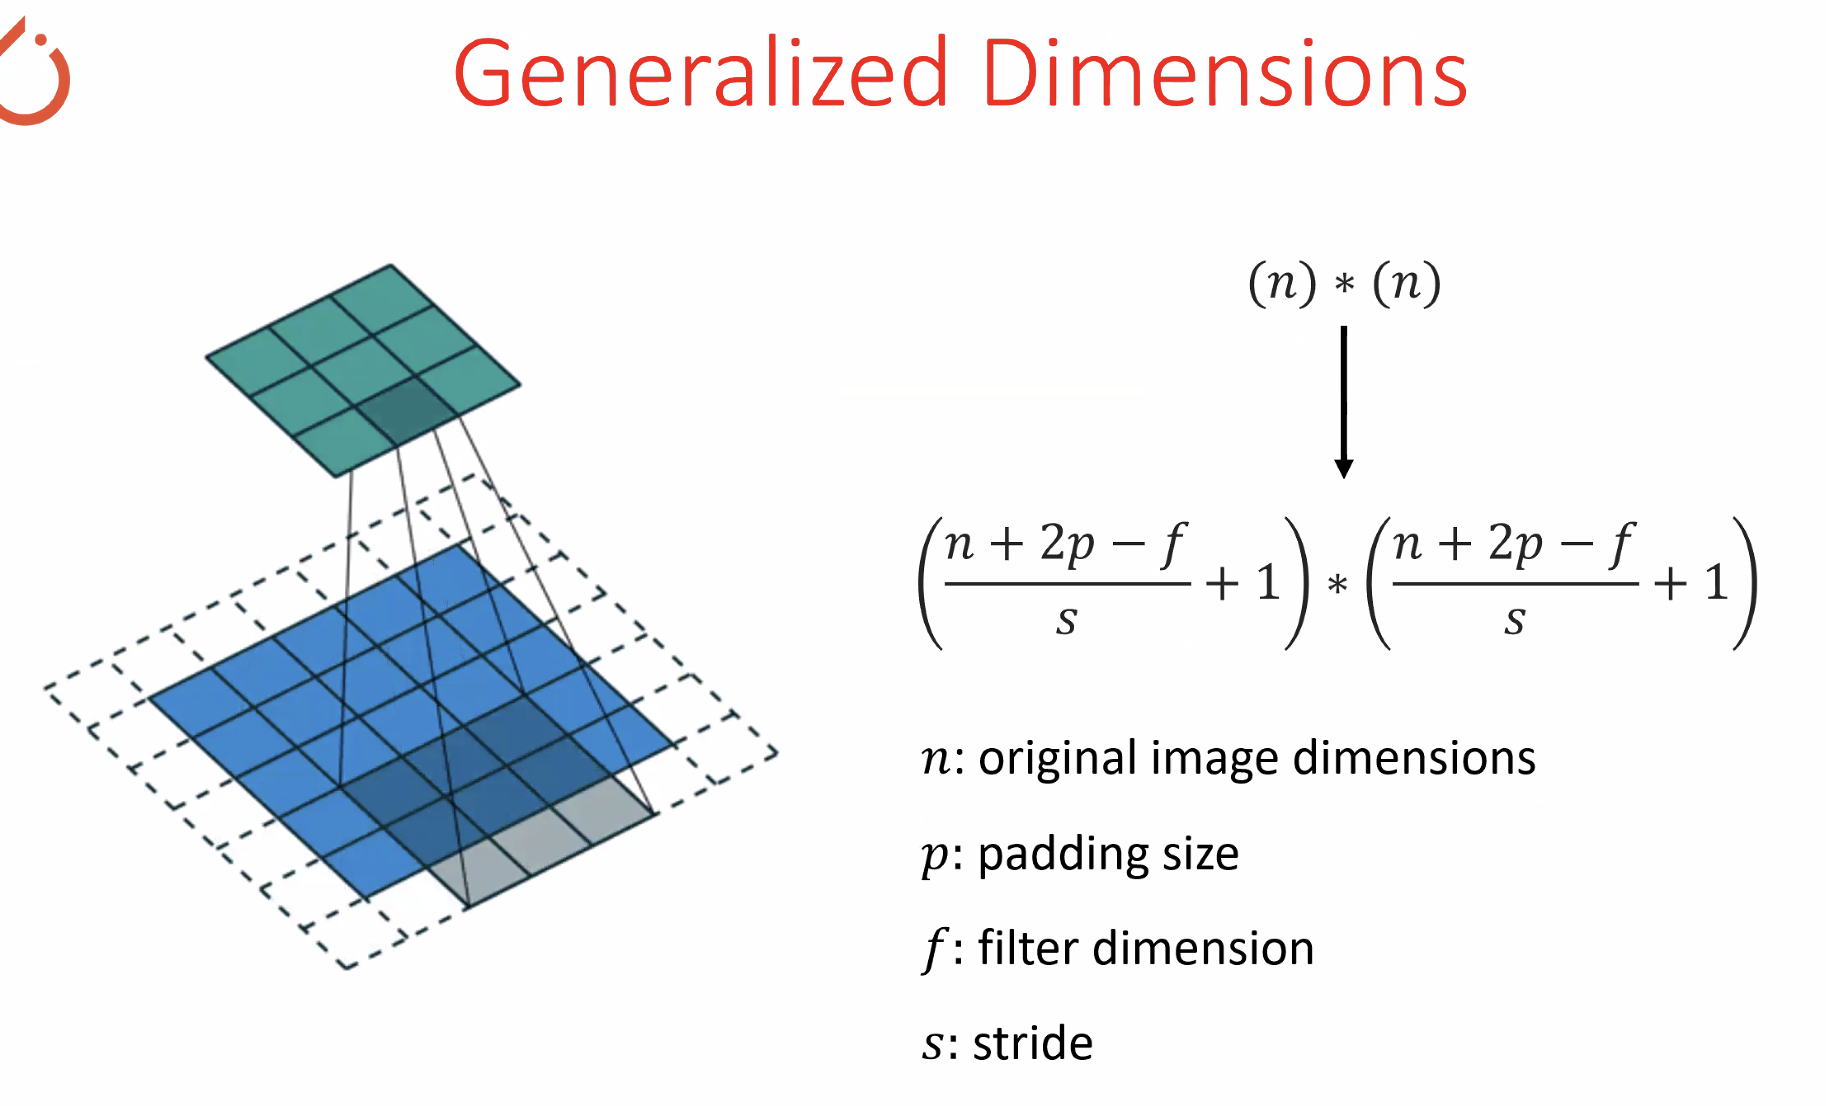
Volumn Convolution
用于处理彩色图像,kernel会有三个通道
卷积核会在输入图像的每个通道上同时滑动。对每个位置,计算卷积核与对应通道的元素乘积再相加。
然后对三个通道(R/G/B)的结果再求和(Sum)。
multiple kernels? 在一层卷积操作中,同时用多个不同的 filter 去扫描输入图像,以提取不同类型的特征。
比如5个filter,每个filter有三个通道,那么就是15个矩阵。每个 filter 都提取不同的图像特征,最后输出是 5 张特征图
Composing CNNs
Pooling Layer
Pooling 是一种对特征图进行 下采样(downsampling) 的操作。 它不会引入新的参数,只是从输入中取代表性值
- 增强模型对位置变化的鲁棒性:不管“眼睛”在这个小区域的左边、右边、还是中间,只要有“眼睛的特征”出现,最大值就会被捕捉到。就算特征在位置上有轻微的变化,只要还在这个小区域里,输出值在数值上是相似的,所以能让模型对轻微的平移或位置变化不敏感。
CNN 优点&缺点
- translation equivariance:同样的参数可以作用于不同的位置。不管眼睛在图片的左上角还是右下角,都能检测到有一只眼睛
- 计算成本高
setting
| |
filter的尺寸应该是1634*4,总共有48个filter matrix, 784个参数 输出16个matrix,每个matrix的结果都是RGB三个通道求和得到的
| |
PyTorch 在创建卷积层 nn.Conv2d(…) 的时候,会自动初始化卷积核权重和偏置参数。
RNN
- h_t = f(W_x x_t + W_h h_{t-1} + b),更新hidden state的时候,需要用到旧记忆和新记忆
- h_1 = f(W_x x_1 + W_h h_0 + b)
- h_2 = f(W_x x_2 + W_h h_1 + b)
- ŷ_t = W_y h_t + b_y
梯度爆炸
∂h_t / ∂h_{t-1} = f’(activate) * W_h
∂h_t / ∂h_{1}, 需要乘(t-1)次的W_h
gradient clipping: 对模型的所有gradient做global norm,如果大于某个threshold, 则scale
many to many
- 每个 time step 都有一个 output(每个h都是一个输出y)
- loss 是 total loss,也就是把所有时间步的 loss 加起来或者平均
sequence to sequence

encoder: 最后输出context vector, c=h_T,总结了整个句子的含义
decoder: s_t是当前状态。根据 s_t 预测当前词 y_t。s_t由三个东西决定:
- 上一个输出词 y_{t-1}
- 上一个 decoder hidden state s_{t-1}
- encoder 给的 context vector c
问题:输入序列所有信息都必须塞进一个固定长度 context vector。 输入越长,信息越容易丢。
LSTM
- 用sigmoid, Tanh激活函数
- cell state: long term memory
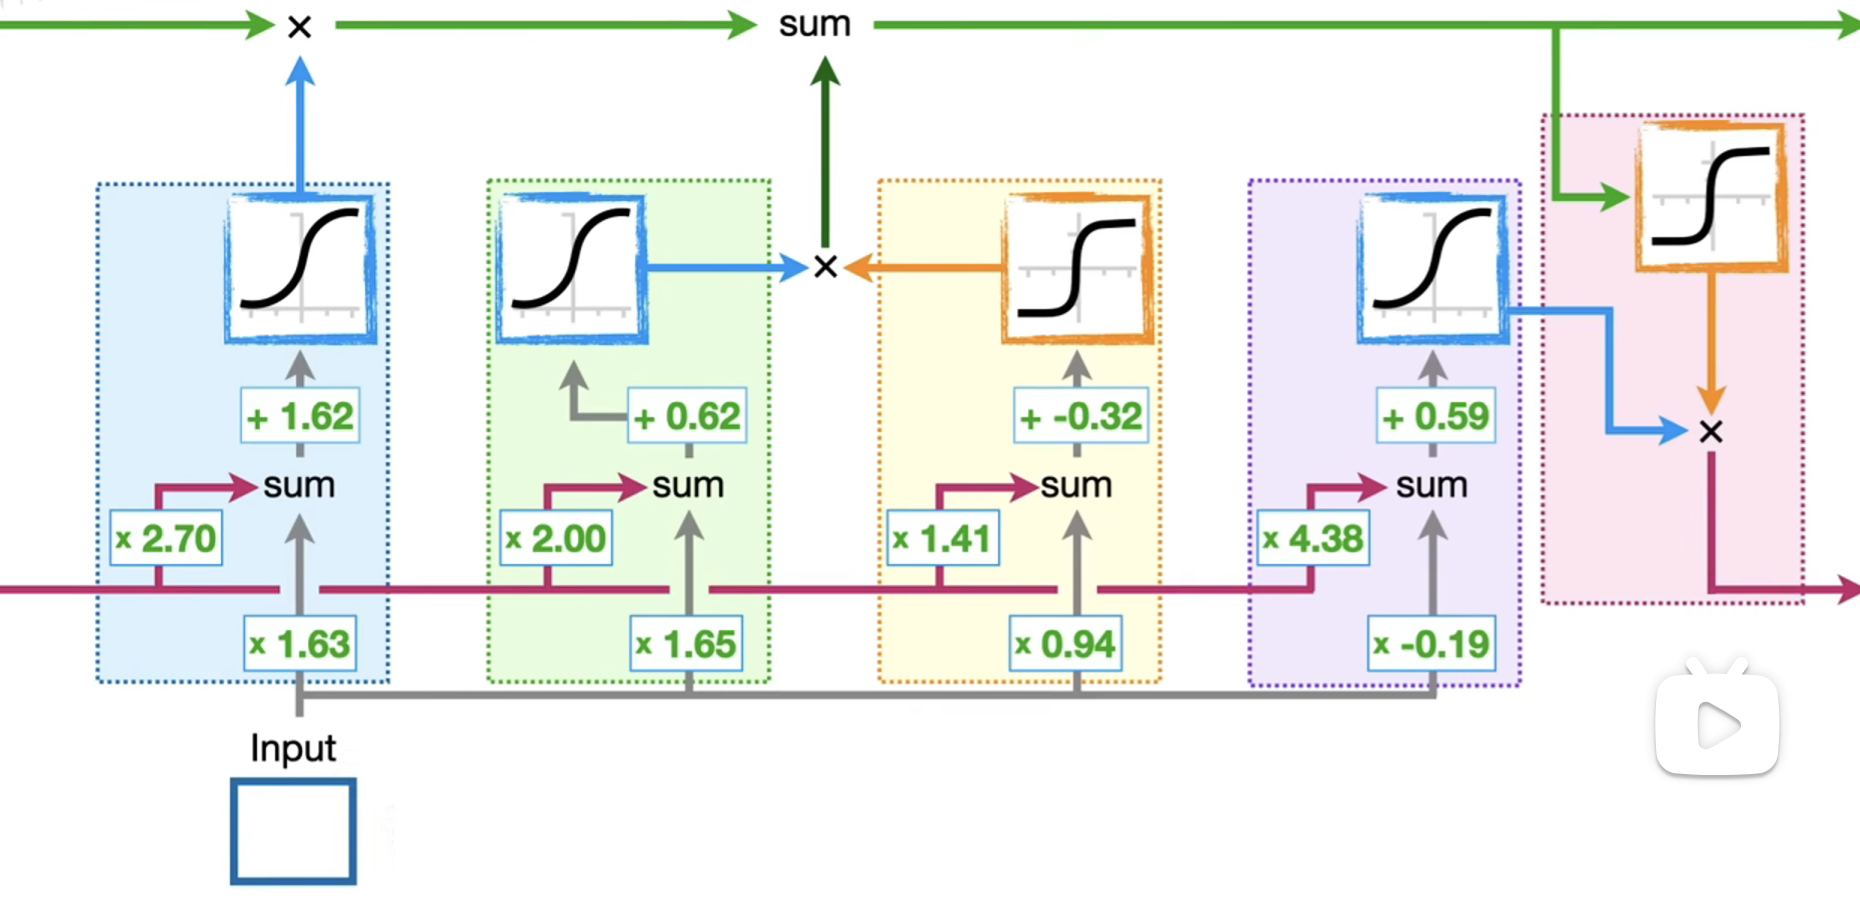
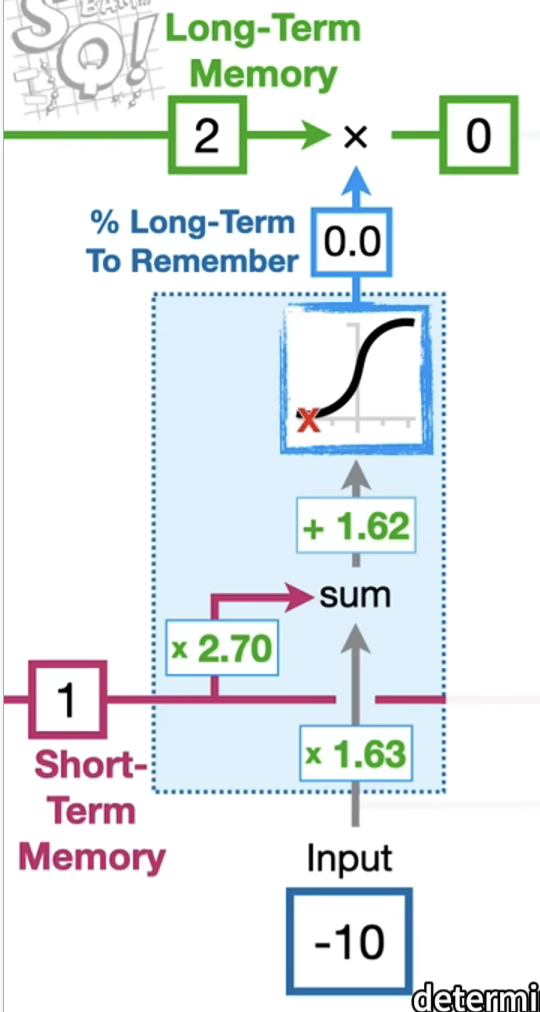
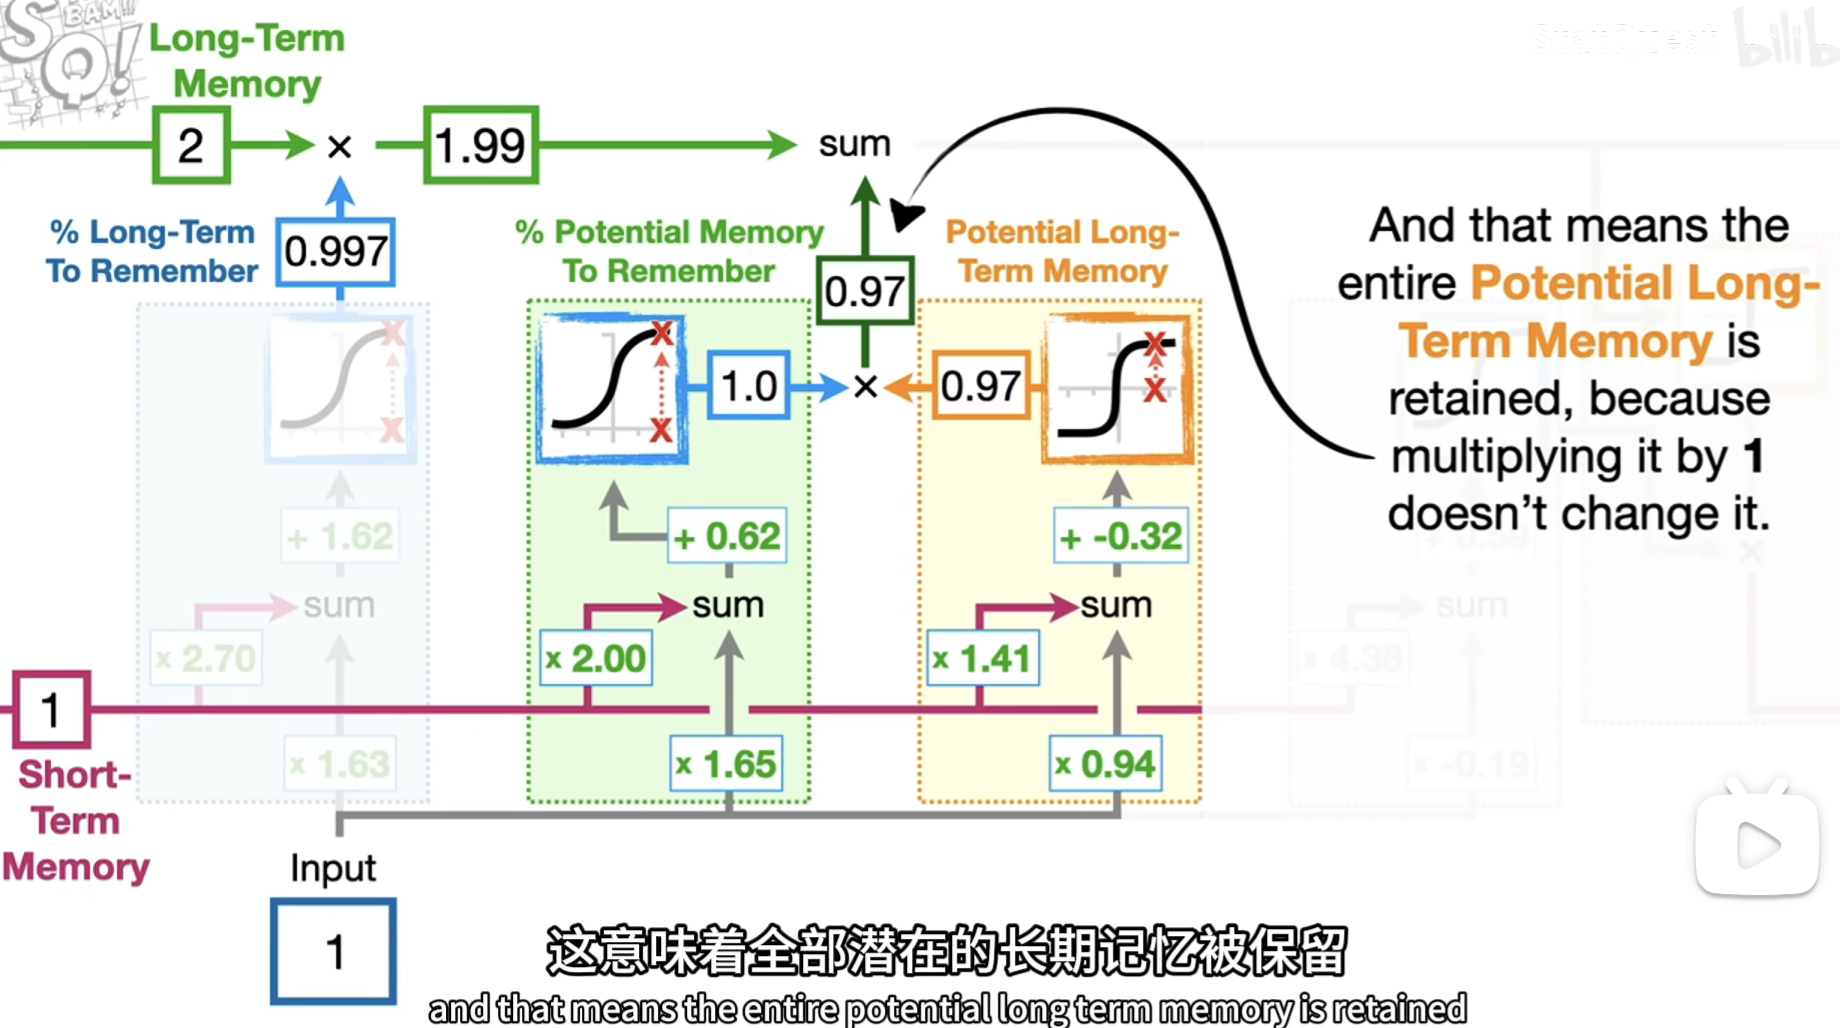
- short-term memory和input分别乘上权重,获得他们的和,加上bias value, 再做sigmoid. 得到的数值代表long-term memory被记住的百分比,这个也叫作Forget Gate
- 第二步:这里右边的block表示potential
long-term memory 的计算,是input和short-term memory的加权之和,加上bias,然后再做tahn,得到的结果也叫candidate state.
左边的block的计算结果是:百分之多少的potential long-term memory被记住。这一部分叫做input gate
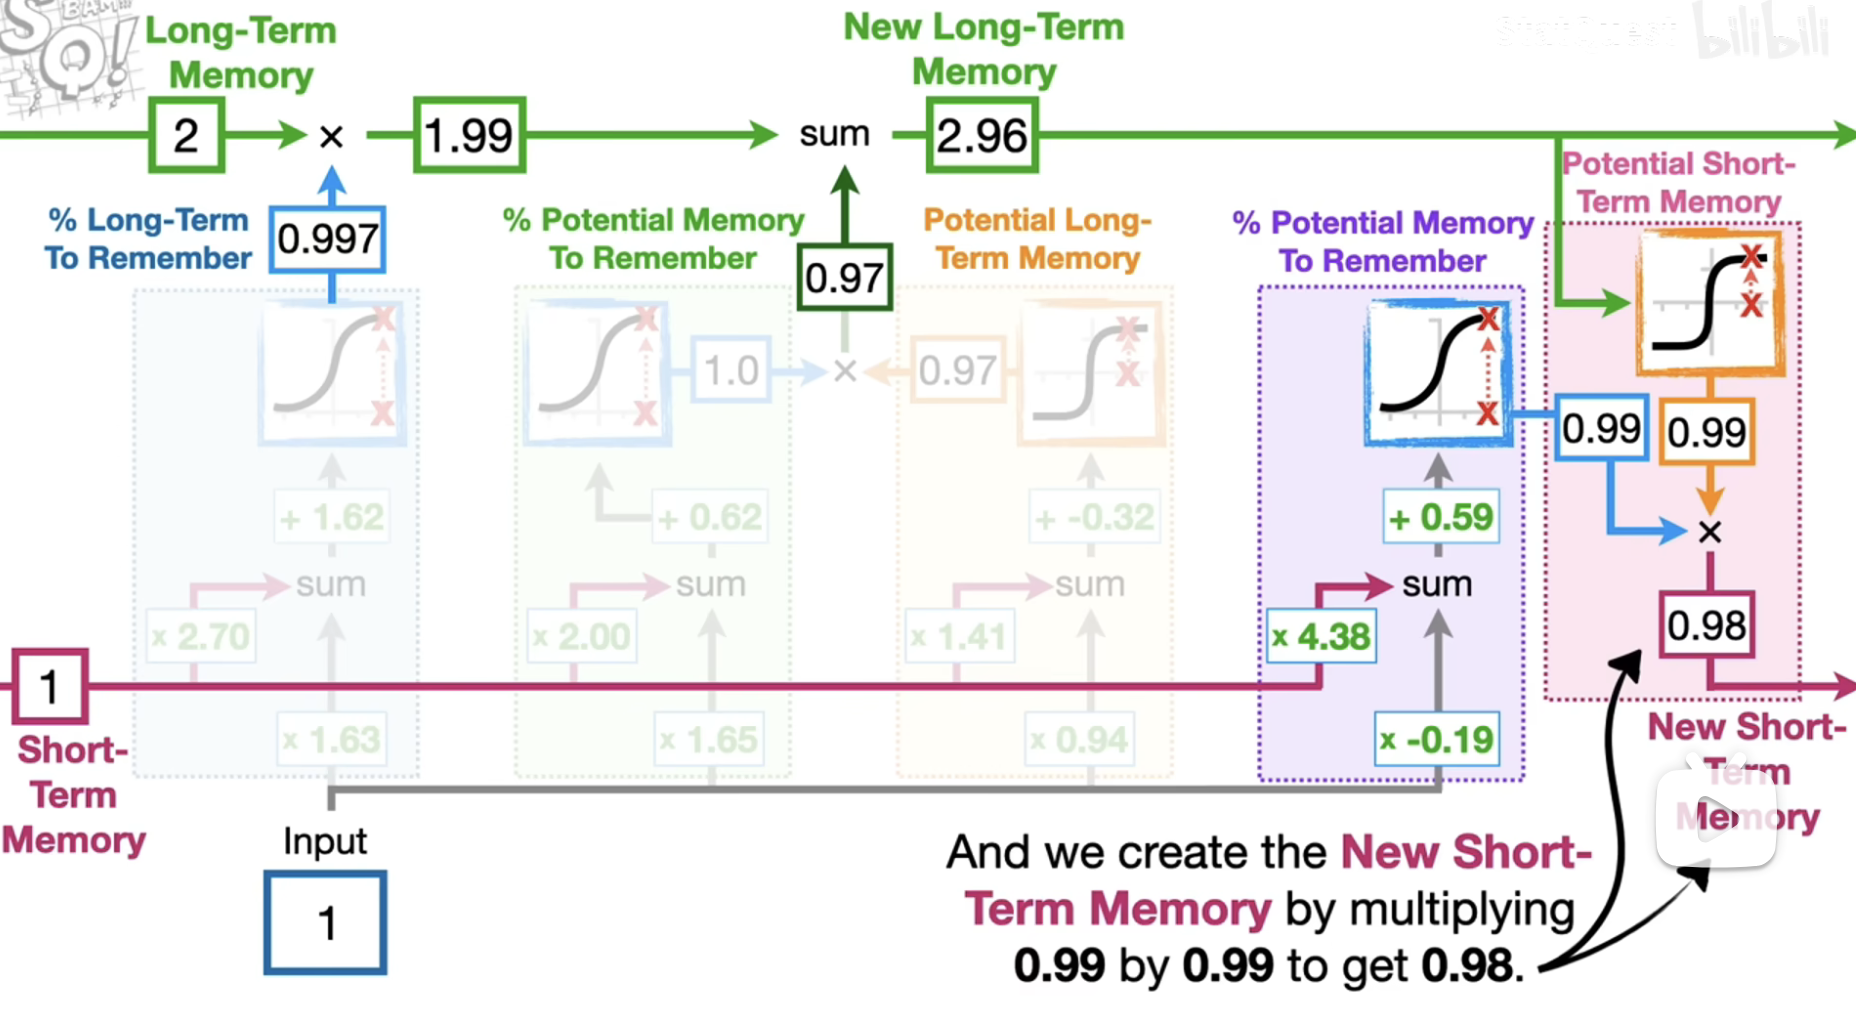
- update short-term memory
- 右边那一块是potential short-term memory.更新后的cell state做tahn, 即可得到
- 左边是代表百分之多少的potential short-term memory我们希望保留。它也是通过short-term memory和input加权求和,然后做sigmoid求出来的
- 拿百分比和potential short-term memory相乘,得到新的short-term memory,也叫做output state(hidden state)
Transformer
RNN with Attention

- 在decoder的每一步,算一个weighted context vector. 对于每个h_i, 都有一个attention score, e_{t,i}
- 当前 decoder 的状态 s_{t-1} 和 encoder 的每个 hidden state h_i, 算一个匹配分数 e_{t,i},然后做softmax, 得到e_{t,i}
- Attendtion思想
- Q = decoder states s_t
- K/V = encoder states h_i
- output = context vectors c_t
Attention
 q=x@W_Q
- similarity: e[N_x]。每个q对每条data做dot product, 得到一个similarity score,拼接在一起得到e[N_x]
- 对e[N_x]做scaled softmax, 得到此query对于每条data的attention权重,即a[N_x]
- 用a[N_x]对data做weighted sum, 得到output vector y: [D_x]. 这里是一个简化的写法,X同时充当了data和V。
- 得到的y,是一个token的query vector把这个sequence里面所有的token看一遍之后,得到的context vector
cross attention

- Q:[N_q, D_q],有多个query. K和V都是data X的learnable projection, K: [N_x, D_q], V: [N_x, D_v]。注意V的维度可能与K不一样
- Q @ K_T, 得到E:[N_q, N_x], 每一行代表一个query对所有data的similarity,然后对每一行做softmax,得到一个query对所有data的attention score
- Y = A @ V, [N_q, D_v]
Cross-attention 看的是 Q 和 K/V 是否来自不同的序列,而不是 T 和 S 是否相等。
- T:Query 序列长度
- S:Key/Value 序列长度
self attention

- masked self attention: 计算similarity score的时候,不让前面data的query去看后面的v, 即把score设置为-inf

- mha: run多份attention layer, 然后把结果拼接起来。
- attention层的输入输出dimension为D,比如有H个heads, 那么就run H遍计算,每次计算时QKV的维度为D_H=D/H,最后把H份结果拼接起来,输出层的dim就仍然是D
- In practice, compute all H heads in parallel using batched matrix multiply operations
- similarity矩阵和V相乘时,时间/空间复杂度为O(N^2)。如果用FlashAttention,空间复杂度为O(N)
Transformer Block

- 第一层是个self attention, 输入输出维度一致,然后加一层ResNet
- Layer Normalization,对每个hidden vector的所有dimension做normalization和scale+shift
- Feed Forward: 对每个vector做MLP层,通常是两层。MLP(x) = W2 * activation(W1 * x + b1) + b2。先升维再降维。然后加一层ResNet。
- 比如输出的x是D维的,那么W1:[D,F], W1 @ X:[F]。这是升维. 然后经过激活函数,得到a:[F]
- 再经过W2:[F,D], W2 @ a, 得到[D]
- Layer Normalization
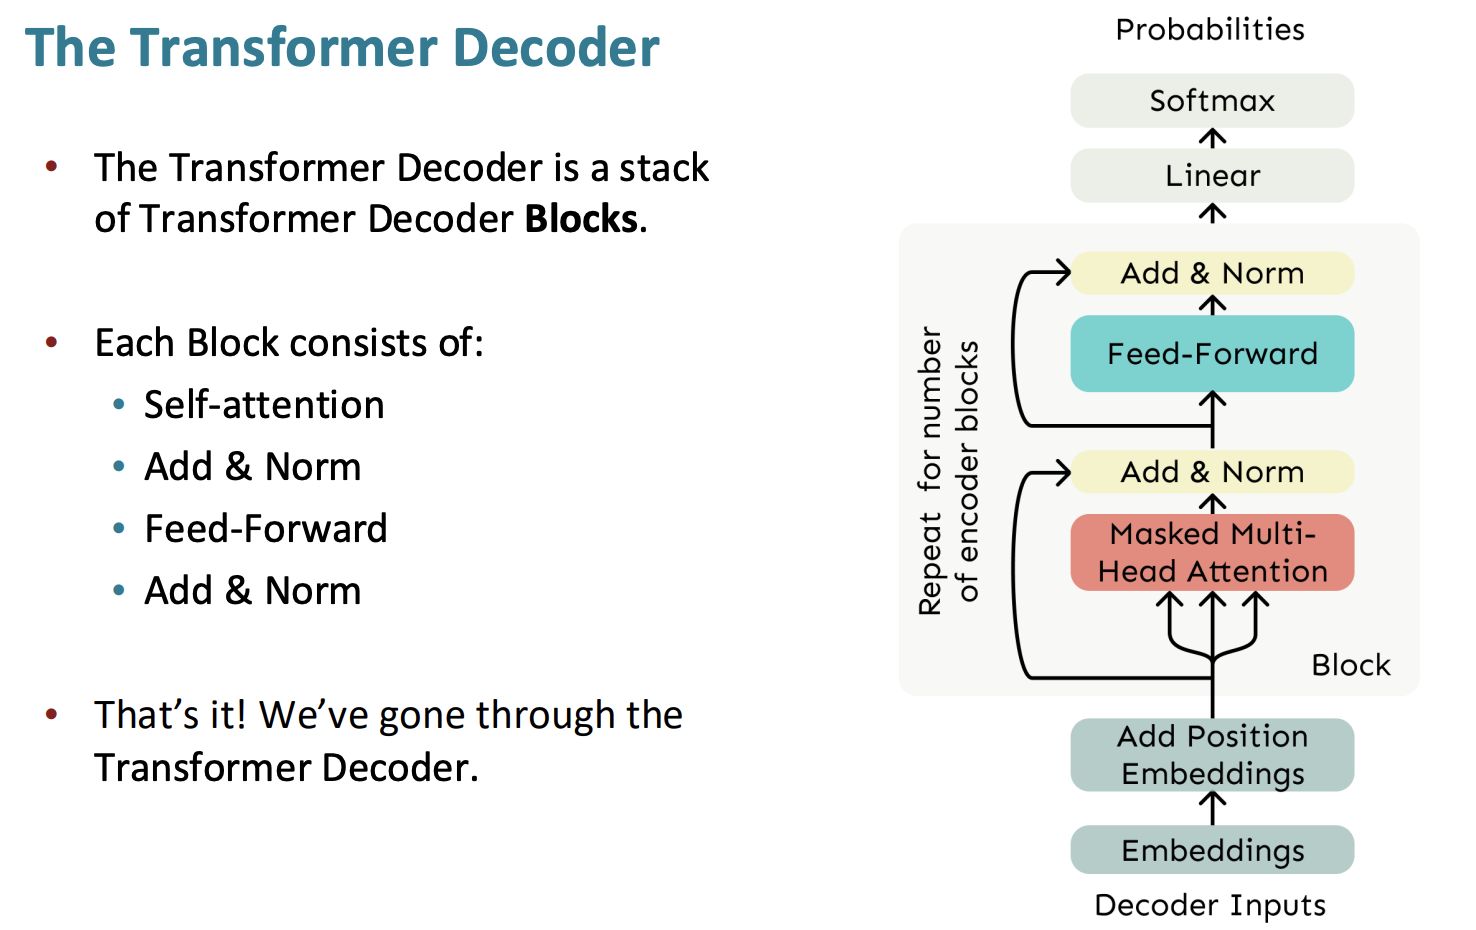
- 一个decoder最先输入embedding和,再加上position embedding, 然后经过多层decoder blocks
- 最后经过linear层,得到每个可能的下一个token的prob
Language Model
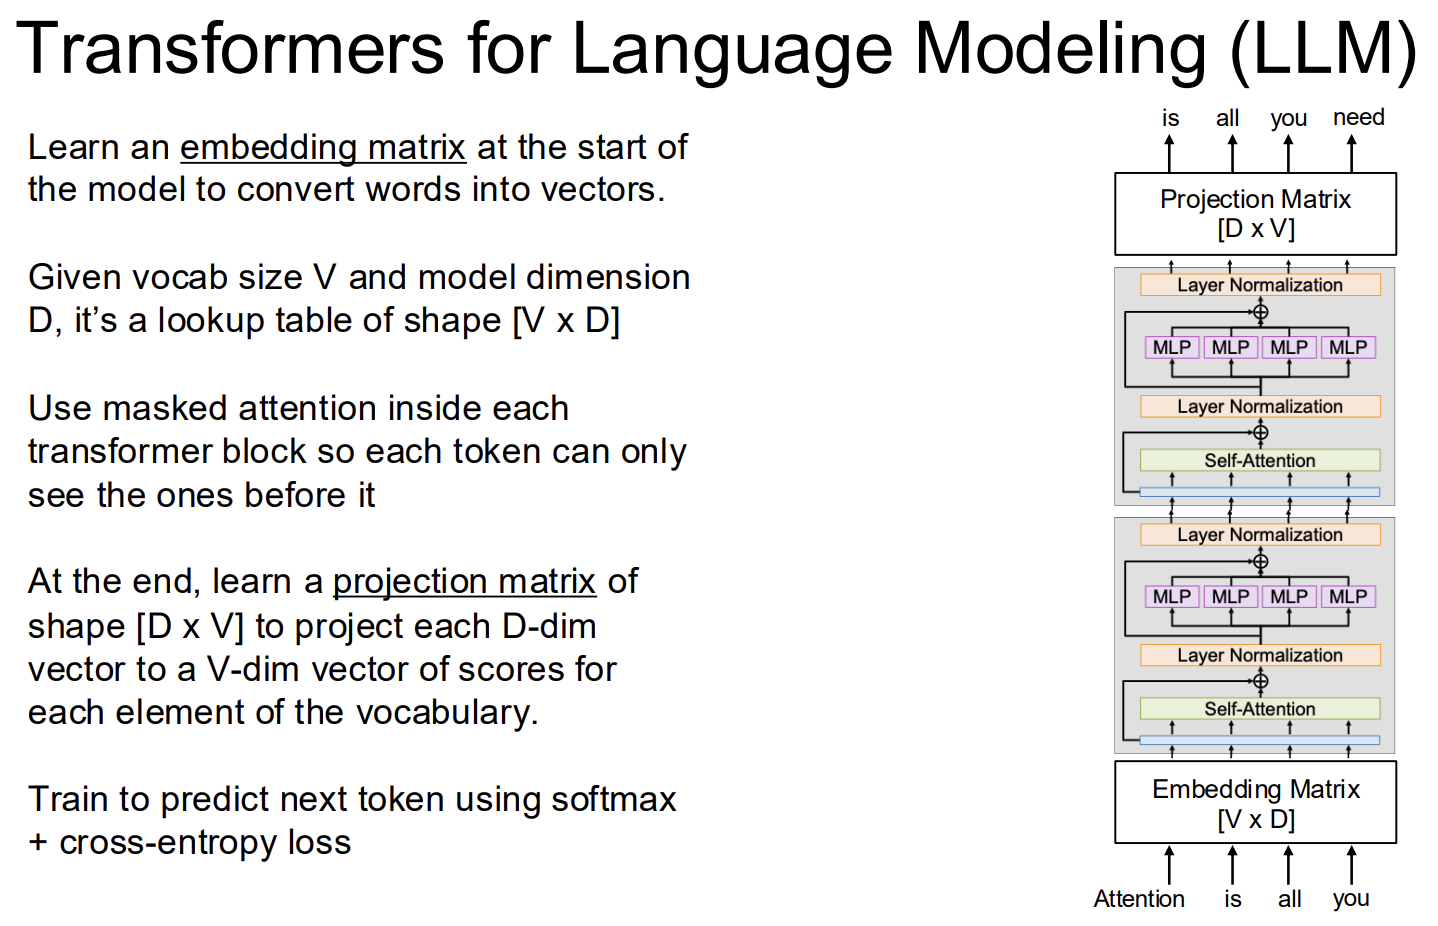 这是一个deceoder-only Transformer,比如GPT, LLaMA
- learn一个embedding matrix, 把token映射成向量。如果vocab size=V, dim=D, 则table: [V, D]
- 在transformer block里面用masked attention
- learn一个projection matrix.
- 这一步的input,是每个位置有一个h_i: [D]。但是我们希望这一个位置输出下一个位置的预测词,也就是一个dim=V的vector
- logits_i = h_i W_out。 W_out:[D, V], logits_i: [V], 然后做softmax
encoder-decoder Transformer
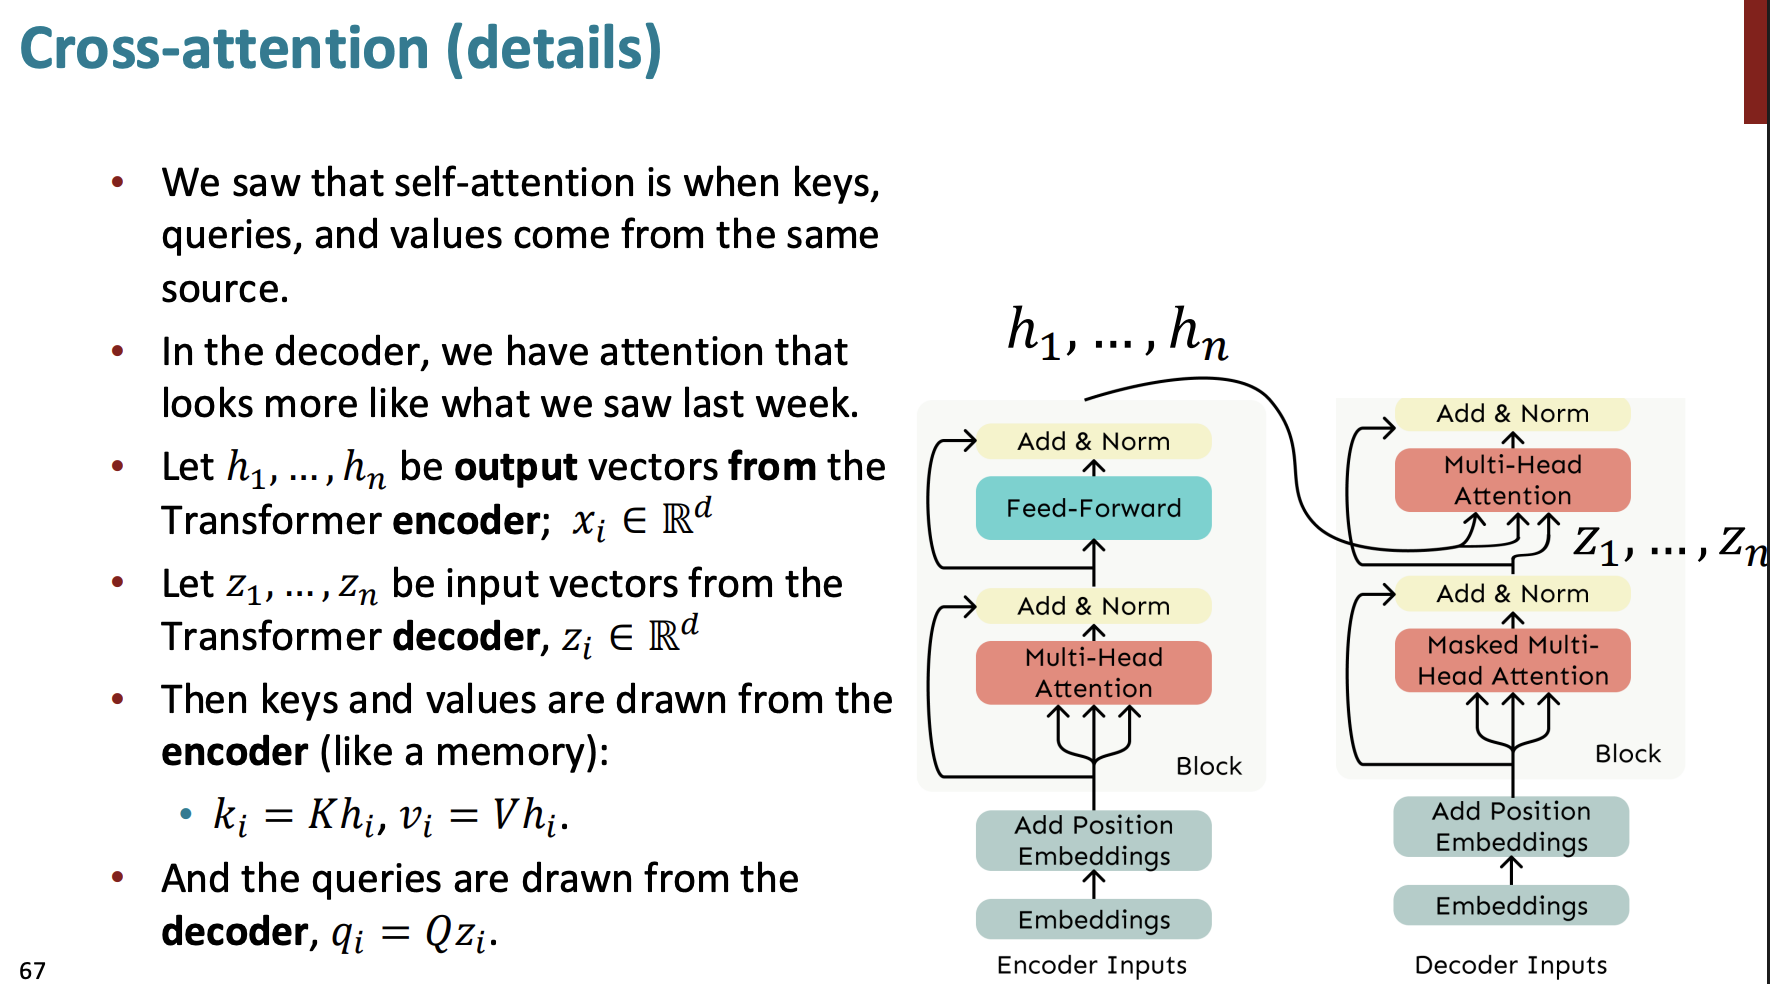
- 也叫seq2seq Transformer
- 用于 machine translation的Original Transformer长这样
- source input 进 encoder
- target prefix 进 decoder
- decoder cross-attends to encoder outputs
- 输出 target token logits
- 计算 cross-entropy loss
- 一次 backprop 同时更新 encoder + decoder + embeddings + projection
FlashAttention
- A=softmax(Q @ K_T), [N,N], 瓶颈在于N太大
- 每次只算 A 的一小块,用完就丢,不存完整 A
Tiling

- Tiling = 把
Q / K / V按 token block 切开 - 每次从 HBM 里加载一小块
Q_block, K_block, V_block到 SRAM - 在 SRAM 上计算:
score_block = Q_block @ K_block^Tlocal_softmax(score_block)partial_output = local_softmax(score_block) @ V_block
- 这样避免把完整的
[N, N]attention matrix 写入 HBM
Online Softmax
FlashAttention 用 online softmax 来实现这个 scaling。
它在处理每一行时维护三个东西:
- running max:目前见过的最大 score
- running sum:目前 softmax denominator
- running output:目前累积的 attention output
当新的 K/V block 进来时:
- 计算这个 block 的局部 scores
- 更新 running max 和 running sum
- 根据新的 normalization factor rescale 旧 output
- 加上当前 block 的 partial output
ViT
 ViT = 把 image 切成 patches,把每个 patch 当成一个 token,然后丢进 Transformer。Encoder-Only.
- 2d positional encoding
- 不用masking
- 如果是分类任务,一张图需要用一个D-dim的vector来表示,最后对输出的[N, D] matrix做个mean pooling. 然后再接一个linear layer, 变成C-dim vector,然后softmax. (C表示class数量)
RL
Markov Decision Process
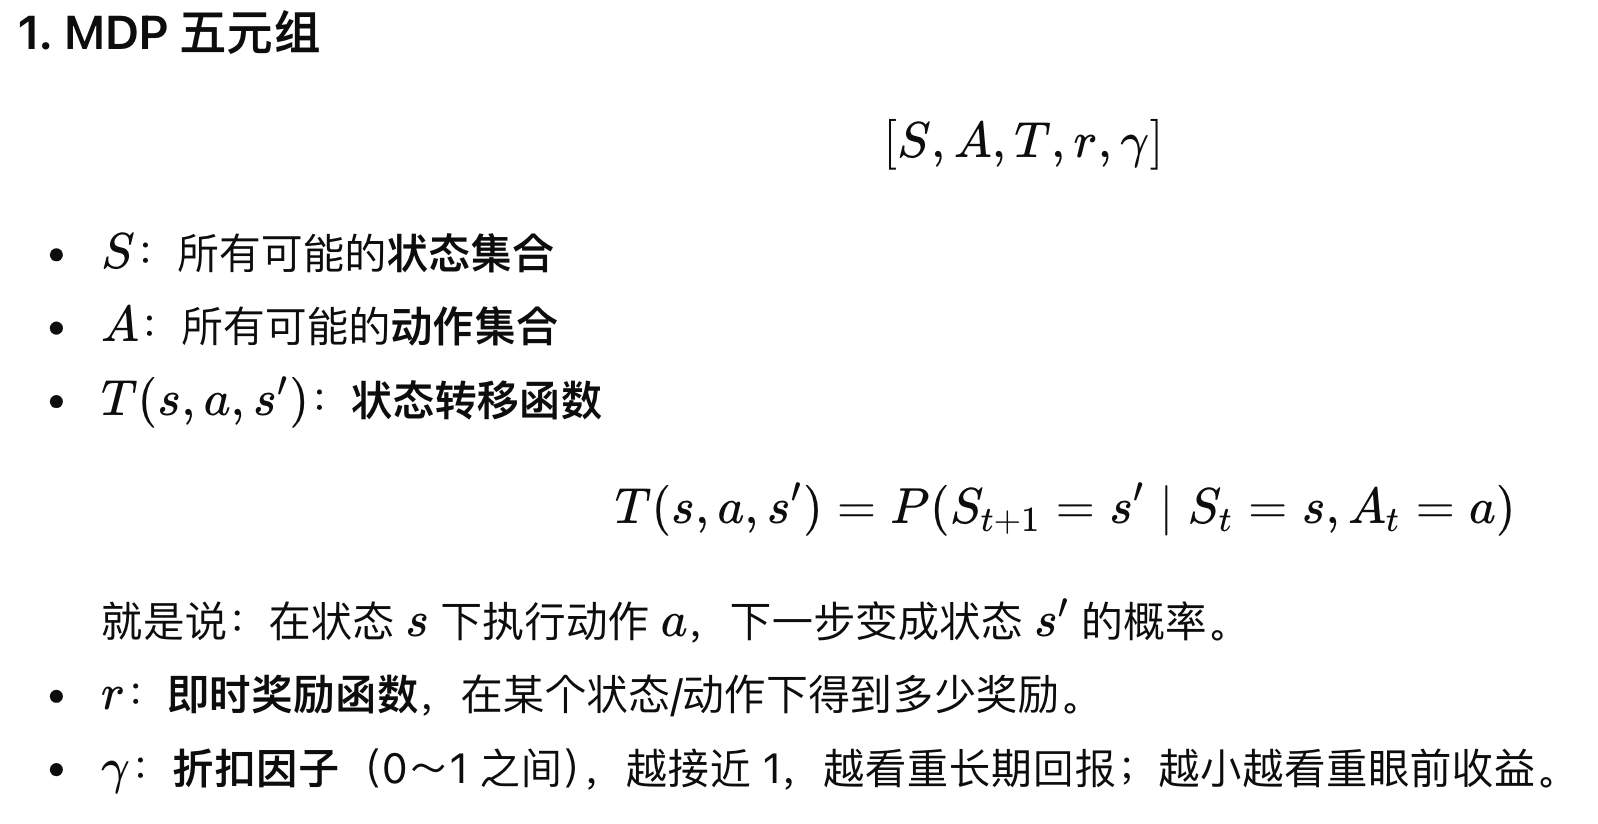
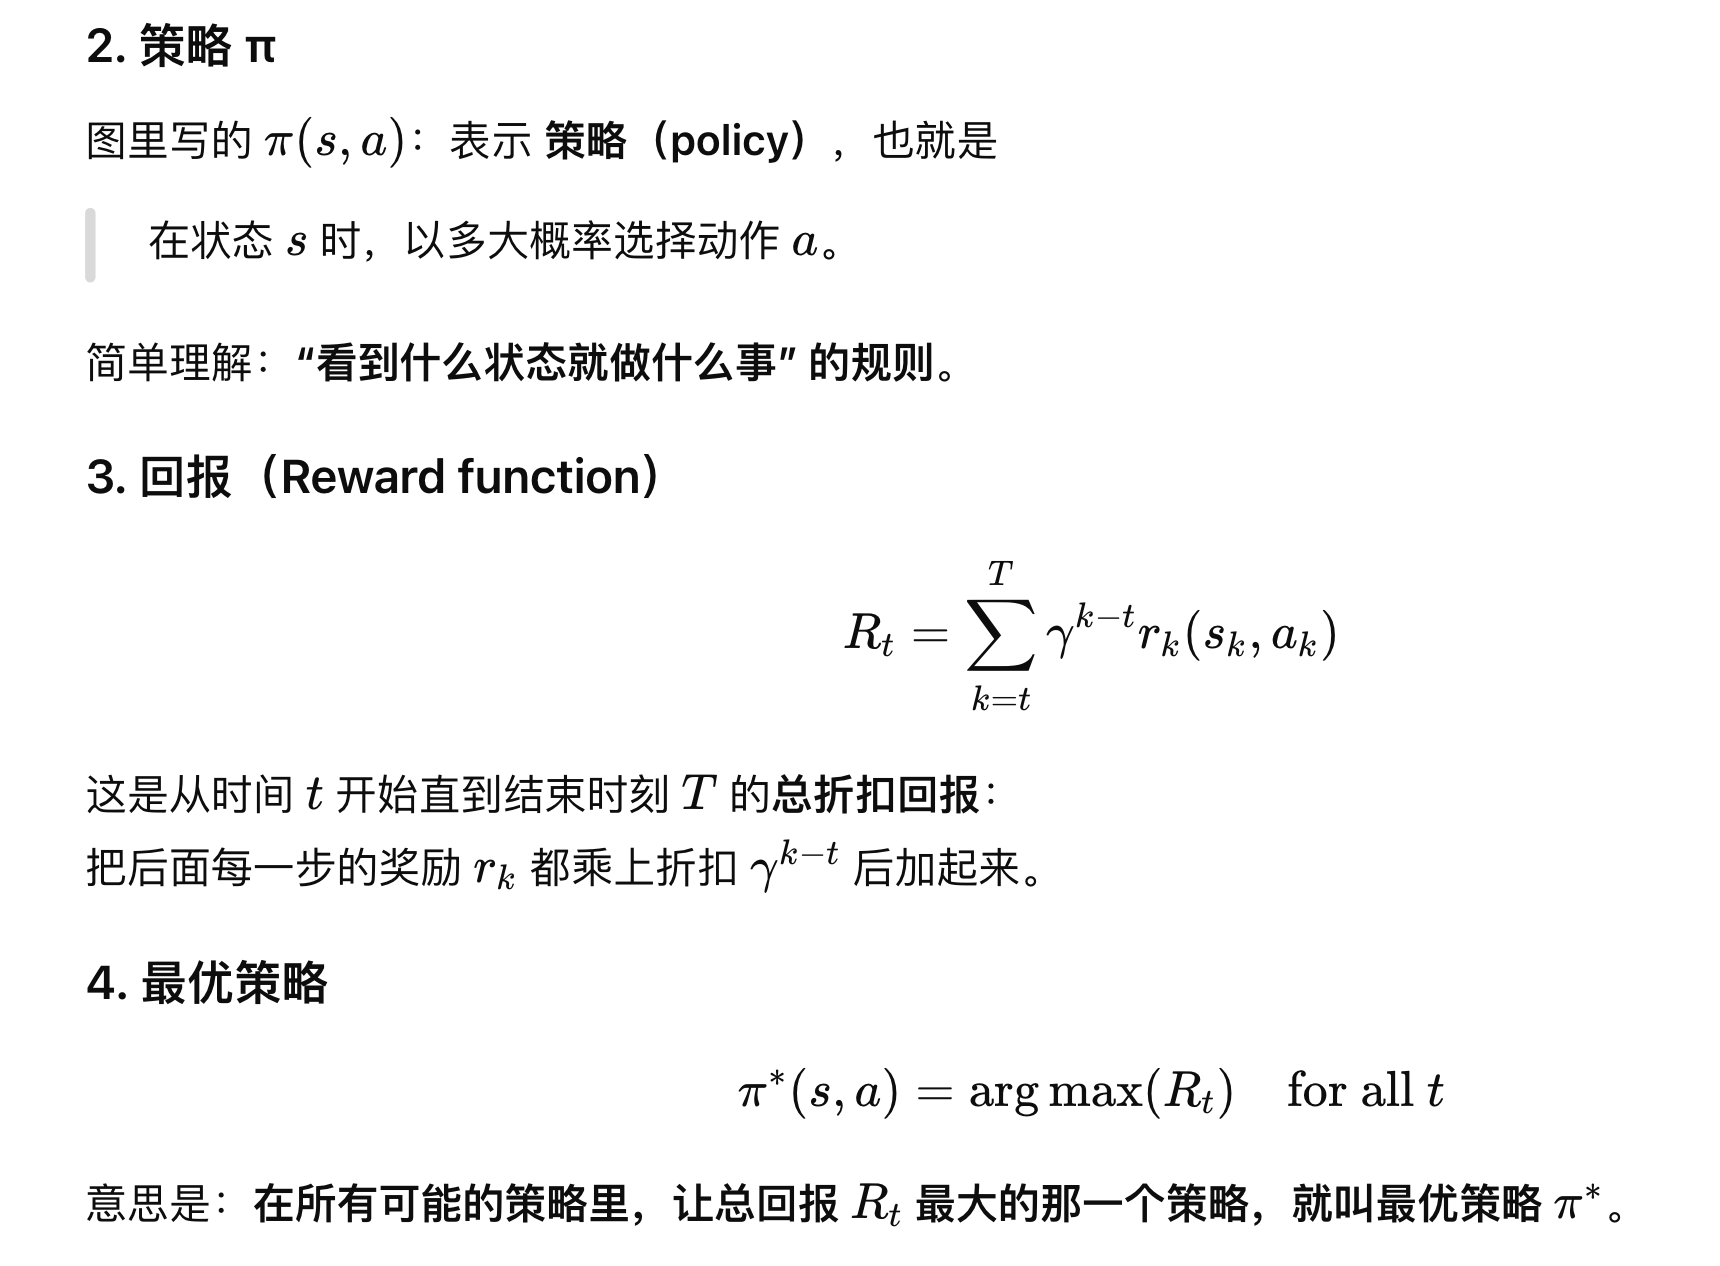 需要学习策略
Q-Learning
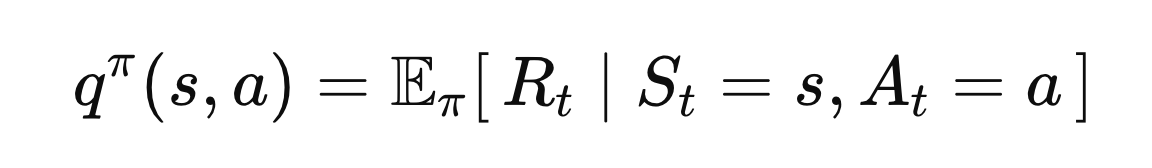 Q值的含义是:在s状态下,选择行动a,并在之后都按照pi策略行动,这样在最终获得的奖励期望值
一开始的Q(s,a)是随便给的。
对于某个状态s1,现在知道Q(s1,a1),Q(s1,a2),Q(s1,a3),…,从里面选择一个最大的Q,采取对应的行动,比如a3
把s1和a3丢给环境,环境按状态转移函数抽样,返回新状态s’和即时奖励r
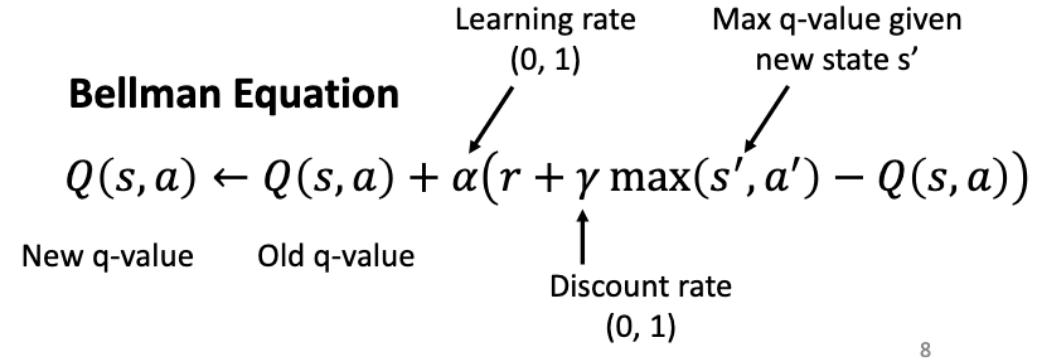
既然现在得到了新的s’,就可以得到下一个状态的Q值,用它去更新当前Q(s,as)
Learning rate: how much the new experience will influence or update our current estimate.
Discount rate: if it’s close to 0, we care more about immediate rewards; if it’s close to 1, we also place significant value on future rewards.
DQN
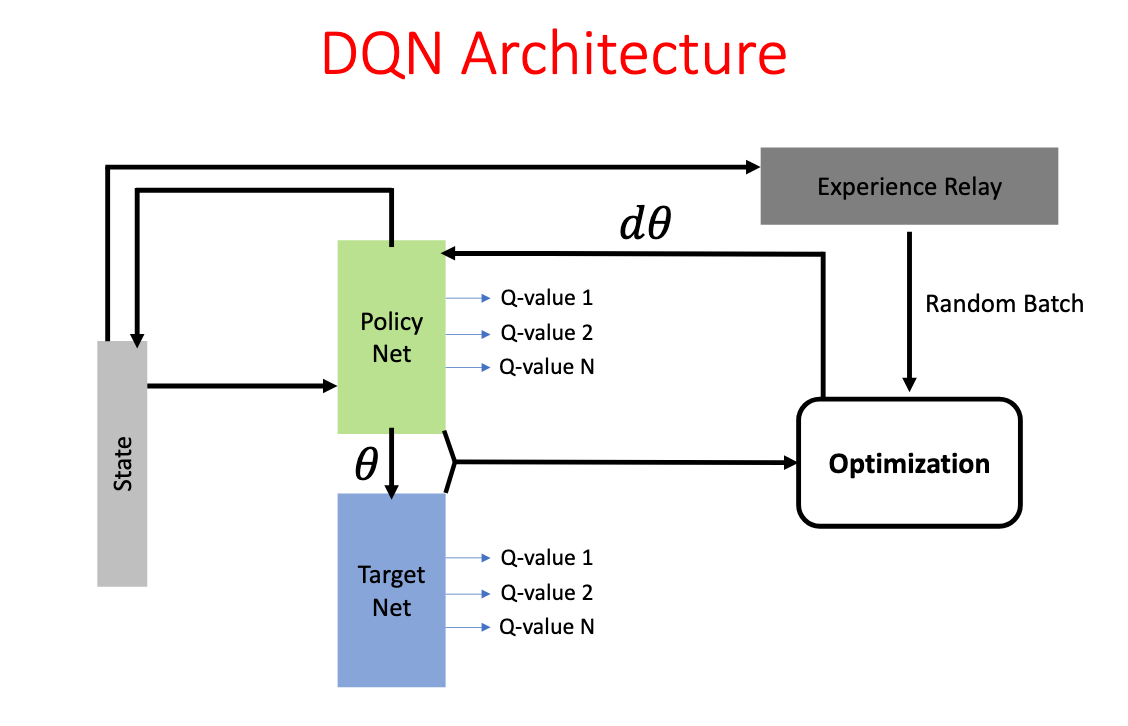
- policy net: 输入当前状态,输出每个动作的Q-value. 这里的参数是back prop来更新的
- target net: 输入下一个状态,输出每个动作的Q-value.它的参数是从policy net处被复制过来的,并且很久才复制一次
- experience relay: 里面存放了大量(s, a, r, s’)样本,每次训练从里边随机取一个 batch
- optimization: 随机抽一个 batch,计算loss,并更新policy net的参数